MilleMiglia : un générateur d’instances réaliste pour la logistique du middle mile
MilleMiglia est un générateur qui produit des instances réalistes de logistique du segment intermédiaire pour l’analyse comparative et la recherche. Ce guide explique ce qu’il crée, pourquoi le réalisme importe pour les problèmes de routage et de consolidation, et comment les praticiens peuvent utiliser les instances générées pour tester des algorithmes avant de les déployer sur des réseaux de fret en exploitation.
Tags
Résumé rapide
MilleMiglia est un générateur qui produit des instances réalistes de logistique du segment intermédiaire pour l’analyse comparative et la recherche. Ce guide explique ce qu’il crée, pourquoi le réalisme importe pour les problèmes de routage et de consolidation, et comment les praticiens peuvent utiliser les instances générées pour tester des algorithmes avant de les déployer sur des réseaux de fret en exploitation.
MilleMiglia : un générateur d’instances réalistes pour la logistique du middle mile
La recherche en optimisation dépend entièrement de ses instances de test. Une heuristique de routage de véhicules qui semble excellente sur un ensemble bien ordonné de points répartis aléatoirement peut se comporter très différemment dès que la demande se concentre le long d’un corridor autoroutier, que les conducteurs atteignent les limites d’heures de service et que les dépôts ne sont pas interchangeables. Google Research a publié MilleMiglia, décrit comme un générateur d’instances réalistes pour la logistique du middle mile. Cet article explique à quoi sert cette catégorie d’outil, comment mettre en place un environnement de travail autour de lui, comment réfléchir à sa configuration et à son utilisation et — tout aussi important — où les preuves publiques s’arrêtent et où le jugement d’ingénierie commence.
La source primaire pour tout ce qui est factuel ci-dessous est le billet de blog de Google Research à l’adresse <https://research.google/blog/millemiglia-a-realistic-instance-generator-for-middle-mile-logistics>. L’enregistrement source référencé porte l’horodatage 2026-09-18T17:46:09.000Z. Lorsque je décris des pratiques du domaine, des paramètres de configuration ou un flux de validation, je le dis explicitement et je les traite comme une interprétation plutôt que comme une fonctionnalité documentée.
Pourquoi la logistique du middle mile a besoin de son propre générateur d’instances
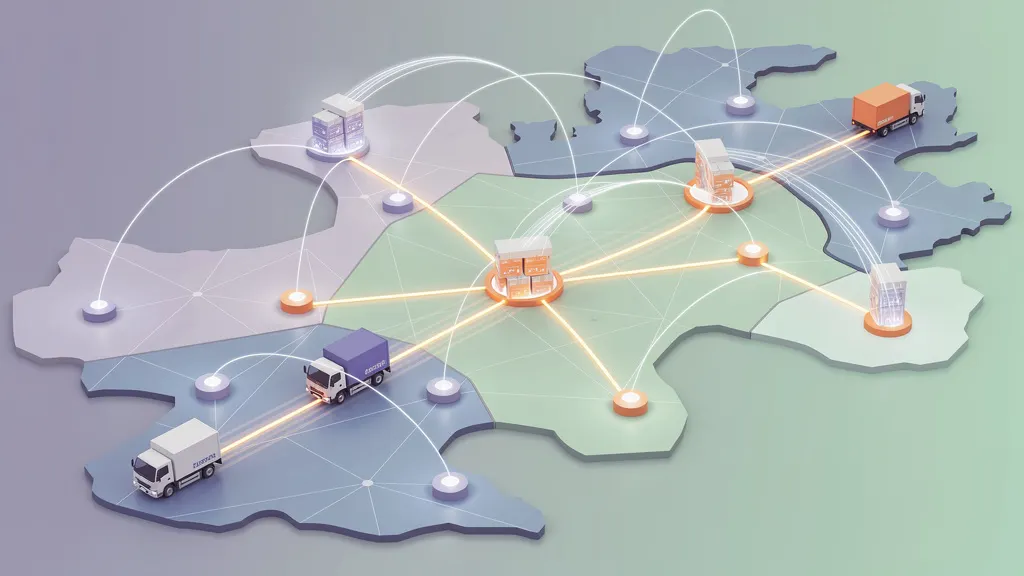
La logistique est généralement divisée en trois étapes. Le first mile couvre l’enlèvement et la consolidation depuis les origines. Le last mile couvre le dernier segment jusqu’à un client ou un magasin. Le middle mile se situe entre les deux : le transport longue distance et régional de fret consolidé entre centres de distribution, centres de traitement des commandes, hubs de tri et cross-docks.
Les problèmes de middle mile ont une forme distinctive :
- Structure en étoile (hub-and-spoke). La demande n’est pas répartie uniformément sur une carte ; elle se concentre sur des sites dont l’emplacement a été choisi des années auparavant pour des raisons sans rapport avec votre algorithme.
- Demande consolidée mais hétérogène. Un chargement de semi-remorque n’est pas un colis. Les classes de fret, les nombres de palettes et les limites volume/poids contraignent tous la manière dont les chargements peuvent être combinés.
- Rythme temporel. Les plannings de ligne (linehaul) sont construits autour d’heures limites, de fenêtres de rendez-vous à quai et de limites de poste. Un itinéraire géométriquement parfait mais qui rate un créneau à quai ne vaut rien.
- Couplage des ressources. Les tracteurs, les remorques et les conducteurs sont des ressources distinctes avec des contraintes distinctes. Les heures restantes d’un conducteur peuvent invalider un plan que la couche de routage croyait réalisable.
- Asymétrie des coûts. Les décisions coûteuses portent généralement sur le nombre de trajets, le nombre de véhicules et le kilométrage à vide — pas sur la séquence exacte des quelques derniers arrêts.
Les instances de référence classiques ont été largement conçues pour une famille de problèmes différente, généralement le last mile ou le routage capacitif générique. Elles sont excellentes pour comparer des algorithmes sur une base commune, mais elles peuvent sous-représenter les caractéristiques structurelles qui dominent la performance du middle mile. C’est cet écart qu’un générateur d’instances réalistes est censé réduire : non pas remplacer les références publiques, mais ajouter une distribution d’instances qui ressemble davantage à ce que les opérateurs affrontent réellement.
Ce qu’est MilleMiglia — et ce que disent les preuves publiques
En s’en tenant strictement à la source primaire, MilleMiglia est un générateur d’instances réalistes ciblant la logistique du middle mile. Le titre de la publication Google Research est le fait d’ancrage ici : un générateur, orienté vers le réalisme, limité au middle mile.
C’est une affirmation plus étroite qu’elle n’en a l’air, et il vaut la peine d’être rigoureux à ce sujet. La description publiée n’ établit pas (d’après les preuves dont je dispose) un format de fichier spécifique, une interface en ligne de commande spécifique, un paquet spécifique sur un registre quelconque, un schéma de paramètres documenté ou des chiffres de référence publiés. Quiconque construit sur MilleMiglia devrait donc considérer la page source officielle comme l’autorité pour les détails d’interface, et traiter cet article comme un guide du flux de travail environnant : configuration de l’environnement, réflexion sur la configuration, construction du harnais et validation du réalisme.
La proposition de valeur d’un tel générateur est la reproductibilité. Au lieu d’espérer qu’un collaborateur dispose du même jeu de données propriétaire que vous, vous partagez une graine, une configuration et un identifiant de version — et les deux parties régénèrent les mêmes instances. C’est cette propriété qui rend les résultats comparables entre équipes.
Prérequis
Avant d’installer quoi que ce soit, vérifiez que vous disposez de ce qui suit. La liste est volontairement prudente et reflète l’outillage général pour ce type d’artefact de recherche.
- Python 3.10 ou version ultérieure. Les piles scientifiques modernes ont largement abandonné les interpréteurs plus anciens. Vérifiez la source officielle pour l’exigence exacte, car c’est elle qui fait foi.
- Un environnement virtuel. N’installez jamais un artefact de recherche dans un interpréteur système ; les conflits de dépendances sont courants dans ce domaine.
- Git, pour obtenir la source et enregistrer le commit exact que vous avez utilisé.
- Bibliothèques numériques de base : NumPy et pandas pour la manipulation des données, NetworkX si vous voulez inspecter la structure de graphe d’un réseau généré, Matplotlib pour les diagnostics.
- Au moins un solveur de routage pour consommer les instances. Google OR-Tools est un choix par défaut raisonnable ; les solveurs commerciaux ou les heuristiques personnalisées fonctionnent tout aussi bien, car la sortie du générateur est constituée de données, pas d’une interface de solveur.
- De la marge disque et RAM. Les balayages d’instances générées sont peu coûteux individuellement et étonnamment volumineux dans l’ensemble. Quelques gigaoctets d’espace disque libre pour les archives d’instances constituent un point de départ raisonnable.
Installation étape par étape
Un avertissement d’abord : les commandes ci-dessous sont un échafaudage d’environnement, et non une transcription des instructions d’installation officielles de MilleMiglia. Lorsqu’une URL de dépôt ou un nom de paquet est requis, j’ai laissé un espace réservé. Prenez ces valeurs sur la page source officielle.
Vérifiez la version de votre interpréteur avant de créer quoi que ce soit.
python3 --versionCréez et activez un environnement virtuel isolé. Le garder en dehors de votre répertoire de projet évite de le valider accidentellement dans le contrôle de version.
python3 -m venv ~/.venvs/millemiglia
source ~/.venvs/millemiglia/bin/activate
Mettez à jour les outils de packaging. Les versions plus anciennes de pip échouent fréquemment sur les wheels modernes.
python -m pip install --upgrade pip setuptools wheelConfigurez un répertoire de travail avec des dossiers séparés pour les instances générées, les fichiers de configuration, les sorties et les journaux. Les séparer rend trivial l’archivage ultérieur d’une expérience.
mkdir -p ~/work/millemiglia/{src,instances,configs,outputs,logs}
cd ~/work/millemiglia
Obtenez la source du générateur. Remplacez l’espace réservé par l’emplacement réel du dépôt indiqué dans la documentation officielle.
git clone <MILLEMIGLIA_REPO_URL> src/millemigliaEnregistrez le commit exact. C’est l’identifiant de version que vous devez citer avec tout résultat.
cd src/millemiglia && git rev-parse HEAD | tee ../../logs/commit.txtSi l’artefact est livré sous forme de paquet Python installable, installez-le en mode éditable afin que les modifications locales prennent effet sans réinstallation.
python -m pip install -e .Installez la pile d’analyse et de résolution environnante. Ce sont des outils généralistes, indépendants du générateur lui-même.
python -m pip install numpy pandas networkx matplotlib
python -m pip install ortools
Figez l’environnement résolu. Reproduire un benchmark exige de reproduire l’environnement, pas seulement la graine.
python -m pip freeze > ../../configs/requirements.lock.txtEnfin, définissez une graine de hachage déterministe pour la session. La randomisation des hachages de Python est une source classique de variation d’une exécution à l’autre dans le code qui itère sur des ensembles ou des dictionnaires.
export PYTHONHASHSEED=0Configuration : de la graine au scénario
La configuration est l’endroit où un générateur mérite ou perd le mot « réaliste ». Le schéma exact des paramètres est un détail d’interface que vous devez lire dans la documentation officielle. Ce qui suit est une liste de contrôle des dimensions qu’un générateur de middle mile doit typiquement exposer, formulée pour que vous puissiez la faire correspondre au format que MilleMiglia utilise réellement. Considérez le YAML ci-dessous comme un modèle illustratif, et non comme un schéma documenté.
# MODÈLE ILLUSTRATIF — faites correspondre ces concepts aux vrais noms de paramètres.
scenario:
  name: "metro-region-baseline"
  seed: 20260918          # ancre de reproductibilité
  horizon_hours: 24       # fenêtre de planification

network:
  num_hubs: 8
  hub_placement: "clustered"   # pas aléatoire uniforme
  service_time_minutes: [20, 45]

demand:
  total_loads: 400
  size_distribution: "lognormal"
  temporal_profile: "peaked"   # heures limites et débuts de poste

fleet:
  vehicle_types: ["van", "straight_truck", "tractor_trailer"]
  capacity_units: "pallets"
  max_drive_hours: 11
  depot_assignment: "fixed"

costs:
  per_mile: 1.0
  per_hour: 1.0
  fixed_dispatch: 150.0
Trois principes comptent plus que n’importe quel champ individuel :
Initialisez tout avec une graine. Un générateur qui n’est pas entièrement déterministe étant donné une graine ne peut pas soutenir une recherche reproductible. Enregistrez toujours la graine avec le nom de l’instance.
Paramétrez des distributions, pas des valeurs uniques. Les opérations réelles varient. Un générateur qui émet un profil de demande fixe produit un seul type d’instance. Des distributions sur les tailles de demande, les temps de service et les profils d’arrivée vous permettent de balayer différents régimes et de trouver où l’avantage d’un algorithme disparaît.
Séparez le réalisme structurel du réalisme statistique. Le réalisme structurel signifie que la topologie du réseau ressemble à un système en étoile — des sites regroupés, des distances plausibles entre hubs, une asymétrie entre les liaisons. Le réalisme statistique signifie que les distributions marginales des chargements, des temps et des coûts correspondent aux données opérationnelles. Un générateur peut avoir l’un sans l’autre, et il vaut la peine de les tester indépendamment.
Exemples d’utilisation
Générer un ensemble d’instances
Le schéma typique est un balayage sur des graines avec une configuration fixe, produisant un fichier d’instance par graine. L’invocation ci-dessous utilise un point d’entrée fictif ; remplacez-le par le vrai.
cd ~/work/millemiglia
for seed in 1 2 3 4 5; do
  python -m millemiglia.generate \
    --config configs/baseline.yaml \
    --seed "$seed" \
    --out "instances/baseline_${seed}.json" \
    2>> "logs/generate_${seed}.err"
done
La boucle écrit l’instance de chaque graine dans son propre fichier et capture stderr séparément, ce qui rend les échecs partiels évidents plutôt que silencieux.
Valider le schéma de sortie
Avant d’injecter quoi que ce soit dans un solveur, confirmez que les fichiers sont complets et cohérents en interne. Les noms de champs ci-dessous sont illustratifs ; adaptez-les au schéma réel.
import json
from pathlib import Path

REQUIRED = {"seed", "hubs", "loads", "vehicles"}

def validate(path: Path) -> bool:
    try:
        data = json.loads(path.read_text())
    except json.JSONDecodeError:
        print(f"{path.name}: malformed JSON")
        return False

    missing = REQUIRED - set(data)
    if missing:
        print(f"{path.name}: missing {sorted(missing)}")
        return False

    total_capacity = sum(v["capacity"] for v in data["vehicles"])
    total_demand = sum(l["size"] for l in data["loads"])
    if total_demand > total_capacity:
        print(f"{path.name}: infeasible by construction "
              f"({total_demand} > {total_capacity})")
        return False

    return True

good = [p for p in sorted(Path("instances").glob("*.json")) if validate(p)]
print(f"{len(good)} instances passed validation")
La vérification des capacités est peu coûteuse et attrape la catégorie la plus courante de bug de générateur : des instances qu’aucun algorithme ne pourrait jamais résoudre.
Comparer les instances générées aux données opérationnelles
C’est le test de réalisme qui compte le plus. Exportez un petit ensemble de caractéristiques par route ou par liaison à partir de vos instances générées et d’un jeu de données de référence, puis comparez les distributions plutôt que les seules moyennes.
import pandas as pd

generated = pd.read_csv("outputs/generated_lane_features.csv")
reference = pd.read_csv("data/reference_lane_features.csv")

for column in ["stops_per_route", "lane_distance_km", "load_utilisation"]:
    print(column)
    print("  generated:", generated[column].describe()[["mean", "std"]].to_dict())
    print("  reference:", reference[column].describe()[["mean", "std"]].to_dict())
Des moyennes concordantes avec des écarts-types discordants sont un signal d’alerte : cela signifie généralement que le générateur produit un cas moyen plausible et une dispersion non plausible. Les solveurs sont souvent plus sensibles à la variance qu’à la tendance centrale.
Tester la résistance d’un solveur à travers différents régimes
Une fois que vous avez un ensemble d’instances, l’expérience naturelle est un balayage de régimes. Plutôt qu’un seul nombre, rapportez une courbe.
import subprocess, time, json
from pathlib import Path

results = []
for inst in sorted(Path("instances").glob("baseline_*.json")):
    start = time.perf_counter()
    proc = subprocess.run(
        ["python", "-m", "your_solver", "--instance", str(inst),
         "--time-limit", "60"],
        capture_output=True, text=True,
    )
    elapsed = time.perf_counter() - start
    results.append({
        "instance": inst.name,
        "seconds": round(elapsed, 3),
        "ok": proc.returncode == 0,
    })

Path("outputs/solver_sweep.json").write_text(json.dumps(results, indent=2))
Exécutez ceci pour plusieurs valeurs du paramètre d’échelle de la demande et vous obtenez une courbe de mise à l’échelle — bien plus informative qu’un score agrégé unique, et beaucoup plus difficile à manipuler.
Valider le réalisme avant de faire confiance à un benchmark
Un générateur qui revendique le réalisme invite une question précise : réaliste selon quoi ? Quatre vérifications méritent d’être institutionnalisées.
Vérification structurelle. Tracez le réseau de hubs. Les sites sont-ils regroupés le long de corridors plausibles, ou dispersés comme par un échantillonnage uniforme ? L’uniformité est la valeur par défaut que le réalisme doit battre.
Vérification distributionnelle. Comparez les marginales pour la taille de la demande, le temps de service et la distance des liaisons aux données de référence. Utilisez des tracés de quantiles, pas seulement des statistiques résumées.
Vérification des contraintes. Vérifiez que les contraintes serrées se activent réellement. Si les limites d’heures de conduite ne s’activent jamais, le générateur n’exerce pas la partie du problème qui rend le middle mile difficile.
Vérification discriminante. Confirmez que les instances séparent les algorithmes. Un benchmark sur lequel toutes les méthodes raisonnables obtiennent un score identique mesure du bruit. À l’inverse, des instances toutes trivialement faciles ou toutes infaisables ne portent aucun signal non plus.
Un générateur qui passe les vérifications structurelles et distributionnelles mais échoue à la vérification discriminante est une simulation fidèle de la mauvaise chose — un mode de défaillance important à surveiller.
Où s’arrêtent les preuves
L’honnêteté sur la frontière fait partie du contenu technique. Les faits vérifiés sont étroits : Google Research a publié un générateur d’instances réalistes pour la logistique du middle mile, sous le titre « MilleMiglia: A realistic instance generator for middle-mile logistics », à l’URL citée plus haut, avec l’enregistrement source horodaté 2026-09-18T17:46:09.000Z.
Tout le reste dans cet article — le modèle de paramètres, le code du harnais, la liste de vérification de validation, la liste des prérequis — relève de la pratique d’ingénierie standard pour travailler avec n’importe quel générateur d’instances dans ce domaine. Il est proposé comme un échafaudage à adapter, et non comme une documentation de l’interface de MilleMiglia.
Deux conséquences pratiques en découlent. Premièrement, considérez la source officielle comme faisant autorité pour l’interface ; ne propagez pas des commandes fictives comme si elles étaient réelles. Deuxièmement, lorsque vous publiez des résultats, citez explicitement la version du générateur et la graine, car c’est ce qui rend la comparaison reproductible.
Conclusion
MilleMiglia comble un véritable écart méthodologique : l’optimisation du middle mile a été largement évaluée sur des instances construites pour d’autres familles de problèmes. Un générateur visant des instances réalistes de middle mile donne aux chercheurs un moyen de tester des algorithmes face à une structure en étoile, une demande consolidée hétérogène et des contraintes temporelles opérationnelles — et, surtout, de le faire de manière reproductible en partageant des graines plutôt que des jeux de données.
Le flux de travail pratique est peu glamour mais efficace. Isolez l’environnement, épinglez le commit, initialisez tout avec une graine, balayez les configurations plutôt que des points uniques, et validez le réalisme sur quatre axes : structure, distribution, activation des contraintes et pouvoir discriminant. La sortie la plus précieuse d’un générateur n’est pas une instance unique, mais la courbe que votre solveur trace à travers une famille d’entre elles — et la restitution honnête de l’endroit où cette courbe s’aplatit.