MilleMiglia: Ein realistischer Instanzgenerator für die Middle-Mile-Logistik
MilleMiglia ist ein Generator, der realistische Instanzen für die Middle-Mile-Logistik zum Benchmarking und für die Forschung erstellt. Dieser Leitfaden erklärt, was er erstellt, warum Realismus für Routing- und Konsolidierungsprobleme wichtig ist und wie Praktiker generierte Instanzen nutzen können, um Algorithmen zu testen, bevor sie sie in Live-Frachtnetzwerken einsetzen.
Tags
Kurze Zusammenfassung
MilleMiglia ist ein Generator, der realistische Instanzen für die Middle-Mile-Logistik zum Benchmarking und für die Forschung erstellt. Dieser Leitfaden erklärt, was er erstellt, warum Realismus für Routing- und Konsolidierungsprobleme wichtig ist und wie Praktiker generierte Instanzen nutzen können, um Algorithmen zu testen, bevor sie sie in Live-Frachtnetzwerken einsetzen.
MilleMiglia: Ein realistischer Instanzgenerator für die Middle-Mile-Logistik
Optimierungsforschung steht und fällt mit ihren Testinstanzen. Eine Vehicle-Routing-Heuristik, die auf einer ordentlichen Menge zufällig verstreuter Punkte hervorragend aussieht, kann sich ganz anders verhalten, sobald die Nachfrage sich entlang eines Autobahnkorridors clustert, Fahrer an Hour-of-Service-Grenzen stoßen und Depots nicht austauschbar sind. Google Research hat MilleMiglia veröffentlicht, beschrieben als realistischer Instanzgenerator für die Middle-Mile-Logistik. Dieser Artikel erklärt, wofür diese Klasse von Werkzeugen gedacht ist, wie man eine funktionierende Umgebung darum herum aufbaut, wie man über Konfiguration und Nutzung nachdenken sollte und — ebenso wichtig — wo die öffentliche Evidenz endet und technisches Urteilsvermögen beginnt.
Die primäre Quelle für alle untenstehenden Fakten ist der Google Research Blogpost unter <https://research.google/blog/millemiglia-a-realistic-instance-generator-for-middle-mile-logistics>. Der referenzierte Quelleneintrag trägt den Zeitstempel 2026-09-18T17:46:09.000Z. Wo ich Domänenpraxis, Konfigurationsparameter oder Validierungsworkflow beschreibe, sage ich das ausdrücklich und behandle es als Interpretation, nicht als dokumentiertes Merkmal.
Warum Middle-Mile-Logistik einen eigenen Instanzgenerator braucht
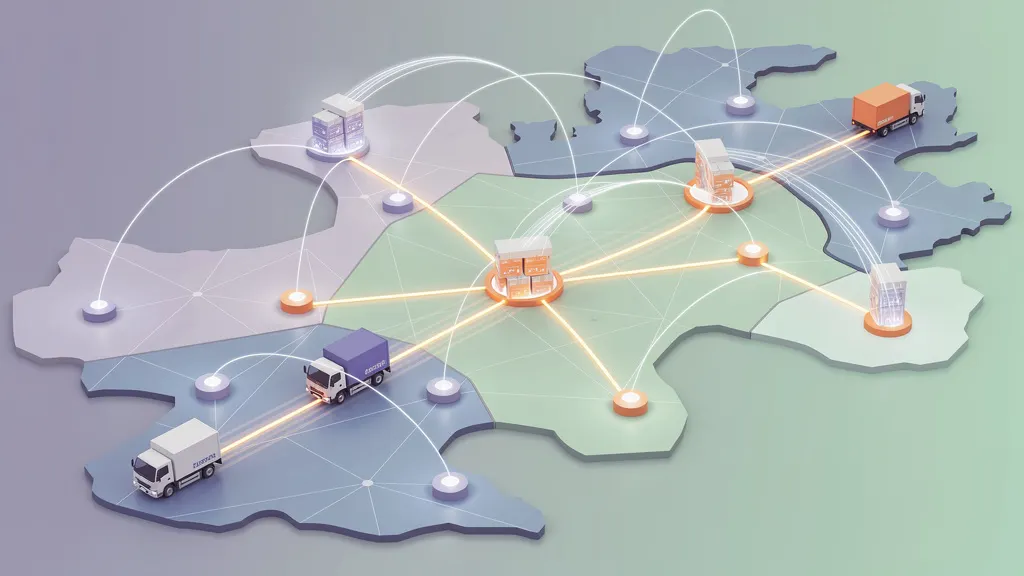
Logistik wird üblicherweise in drei Phasen unterteilt. First Mile umfasst Abholung und Konsolidierung an Ursprungsorten. Last Mile umfasst die letzte Etappe zu einem Kunden oder Geschäft. Die Middle Mile liegt dazwischen: Langstrecken- und regionale Bewegung konsolidierter Fracht zwischen Distributionszentren, Fulfillment-Centern, Sortier-Hubs und Cross-Docks.
Middle-Mile-Probleme haben eine unverwechselbare Form:
- Hub-and-Spoke-Struktur. Nachfrage ist nicht gleichmäßig über eine Karte verteilt; sie konzentriert sich an Standorten, deren Lage vor Jahren aus Gründen gewählt wurde, die nichts mit Ihrem Algorithmus zu tun haben.
- Konsolidierte, aber heterogene Nachfrage. Eine Trailerladung ist kein Paket. Frachtklassen, Palettenzahlen und Volumen- versus Gewichtsgrenzen schränken alle ein, wie Ladungen kombiniert werden können.
- Zeitlicher Rhythmus. Linehaul-Pläne werden um Annahmeschlusszeiten, Dock-Terminfenster und Schichtgrenzen herum aufgebaut. Eine Route, die geometrisch perfekt ist, aber einen Dock-Slot verpasst, ist wertlos.
- Ressourcenkopplung. Zugmaschinen, Auflieger und Fahrer sind getrennte Ressourcen mit getrennten Constraints. Die verbleibenden Stunden eines Fahrers können einen Plan ungültig machen, den die Routing-Schicht für machbar hielt.
- Kostenasymmetrie. Die teuren Entscheidungen betreffen üblicherweise, wie viele Fahrten, wie viele Fahrzeuge und wie viele Leerfahrtskilometer — nicht die exakte Reihenfolge der letzten paar Stopps.
Klassische Benchmark-Instanzen wurden weitgehend für eine andere Problemfamilie entworfen, typischerweise Last-Mile- oder generisches kapazitiertes Routing. Sie sind hervorragend, um Algorithmen auf gemeinsamer Grundlage zu vergleichen, aber sie können die strukturellen Merkmale unterrepräsentieren, die die Middle-Mile-Leistung dominieren. Das ist die Lücke, die ein realistischer Instanzgenerator verkleinern soll: nicht öffentliche Benchmarks zu ersetzen, sondern eine Verteilung von Instanzen hinzuzufügen, die eher dem ähnelt, womit Betreiber tatsächlich konfrontiert sind.
Was MilleMiglia ist — und was die öffentliche Evidenz sagt
Basierend streng auf der primären Quelle ist MilleMiglia ein realistischer Instanzgenerator, der auf die Middle-Mile-Logistik abzielt. Der Titel der Google-Research-Publikation ist hier der Ankerfakt: ein Generator, auf Realismus ausgerichtet, auf die Middle Mile zugeschnitten.
Das ist eine engere Behauptung, als es zunächst scheinen mag, und es lohnt sich, diszipliniert damit umzugehen. Die veröffentlichte Beschreibung belegt (nach der mir verfügbaren Evidenz) weder ein spezifisches Dateiformat, noch eine spezifische Kommandozeilenschnittstelle, noch ein spezifisches Paket in einer Registry, noch ein dokumentiertes Parameterschema oder veröffentlichte Benchmark-Zahlen. Wer auf MilleMiglia aufbaut, sollte daher die offizielle Quellseite als Autorität für Schnittstellendetails behandeln und diesen Artikel als Leitfaden für den umgebenden Workflow: Umgebungseinrichtung, Konfigurationsdenken, Harness-Aufbau und Realismusvalidierung.
Das Wertversprechen eines solchen Generators ist Reproduzierbarkeit. Anstatt zu hoffen, dass ein Kollaborateur denselben proprietären Datensatz hat wie Sie, teilen Sie einen Seed, eine Konfiguration und eine Versionskennung — und beide Parteien generieren dieselben Instanzen neu. Diese Eigenschaft macht Ergebnisse teamübergreifend vergleichbar.
Anforderungen
Bevor Sie irgendetwas installieren, bestätigen Sie, dass Sie Folgendes haben. Die Liste ist bewusst konservativ und spiegelt allgemeines Tooling für diese Art von Forschungsartefakt wider.
- Python 3.10 oder neuer. Moderne wissenschaftliche Stacks haben ältere Interpreter weitgehend aufgegeben. Prüfen Sie die offizielle Quelle auf die genaue Anforderung, da diese die bindende Einschränkung ist.
- Eine virtuelle Umgebung. Installieren Sie ein Forschungsartefakt niemals in einen Systeminterpreter; Abhängigkeitskonflikte sind in diesem Bereich häufig.
- Git, um die Quelle zu beziehen und den genauen verwendeten Commit festzuhalten.
- Zentrale numerische Bibliotheken: NumPy und pandas für die Datenverarbeitung, NetworkX, wenn Sie die Graphstruktur eines generierten Netzwerks untersuchen möchten, Matplotlib für Diagnosen.
- Mindestens ein Routing-Solver zum Konsumieren von Instanzen. Google OR-Tools ist ein vernünftiger Standard; kommerzielle Solver oder maßgeschneiderte Heuristiken funktionieren ebenso gut, da die Ausgabe des Generators Daten sind, keine Solver-Schnittstelle.
- Speicher- und RAM-Reserven. Generierte Instanz-Sweeps sind einzeln günstig und in der Summe überraschend groß. Ein paar Gigabyte freier Speicherplatz für Instanzarchive sind ein sinnvoller Ausgangspunkt.
Schritt-für-Schritt-Installation
Zuerst eine Warnung: Die folgenden Befehle sind Umgebungs-Gerüst, keine Transkription der offiziellen Installationsanweisungen von MilleMiglia. Wo eine Repository-URL oder ein Paketname erforderlich ist, habe ich einen Platzhalter gelassen. Entnehmen Sie diese Werte der offiziellen Quellseite.
Bestätigen Sie Ihre Interpreter-Version, bevor Sie etwas erstellen.
python3 --versionErstellen und aktivieren Sie eine isolierte virtuelle Umgebung. Wenn Sie diese außerhalb Ihres Projektverzeichnisses halten, vermeiden Sie, sie versehentlich in die Versionskontrolle aufzunehmen.
python3 -m venv ~/.venvs/millemiglia
source ~/.venvs/millemiglia/bin/activate
Aktualisieren Sie die Paketierungswerkzeuge. Ältere pip-Versionen scheitern häufig an modernen Wheels.
python -m pip install --upgrade pip setuptools wheelRichten Sie ein Arbeitsverzeichnis mit separaten Ordnern für generierte Instanzen, Konfigurationsdateien, Ausgaben und Logs ein. Diese Trennung macht es trivial, ein Experiment später zu archivieren.
mkdir -p ~/work/millemiglia/{src,instances,configs,outputs,logs}
cd ~/work/millemiglia
Beziehen Sie den Generator-Quellcode. Ersetzen Sie den Platzhalter durch den tatsächlichen Repository-Ort, der in der offiziellen Dokumentation angegeben ist.
git clone <MILLEMIGLIA_REPO_URL> src/millemigliaHalten Sie den exakten Commit fest. Dies ist die Versionskennung, die Sie zusammen mit allen Ergebnissen zitieren sollten.
cd src/millemiglia && git rev-parse HEAD | tee ../../logs/commit.txtWenn das Artefakt als installierbares Python-Paket ausgeliefert wird, installieren Sie es im Editable-Modus, damit lokale Änderungen ohne Neuinstallation wirksam werden.
python -m pip install -e .Installieren Sie den umgebenden Analyse- und Solver-Stack. Dies sind Allzweckwerkzeuge, unabhängig vom Generator selbst.
python -m pip install numpy pandas networkx matplotlib
python -m pip install ortools
Frieren Sie die aufgelöste Umgebung ein. Die Reproduktion eines Benchmarks erfordert die Reproduktion der Umgebung, nicht nur des Seeds.
python -m pip freeze > ../../configs/requirements.lock.txtSetzen Sie schließlich einen deterministischen Hash-Seed für die Sitzung. Pythons Hash-Randomisierung ist eine klassische Quelle für Variation von Lauf zu Lauf in Code, der über Mengen oder Dictionaries iteriert.
export PYTHONHASHSEED=0Konfiguration: vom Seed zum Szenario
Konfiguration ist der Punkt, an dem ein Generator das Wort „realistisch“ verdient oder verliert. Das genaue Parameterschema ist ein Schnittstellendetail, das Sie aus der offiziellen Dokumentation lesen sollten. Was folgt, ist eine Checkliste der Dimensionen, die ein Middle-Mile-Generator typischerweise offenlegen muss, so formuliert, dass Sie sie auf das Format abbilden können, das MilleMiglia tatsächlich verwendet. Behandeln Sie das folgende YAML als veranschaulichende Vorlage, nicht als dokumentiertes Schema.
# VERANSCHAULICHENDE VORLAGE — ordnen Sie diese Konzepte den echten Parameternamen zu.
scenario:
  name: "metro-region-baseline"
  seed: 20260918          # Reproduzierbarkeitsanker
  horizon_hours: 24       # Planungsfenster

network:
  num_hubs: 8
  hub_placement: "clustered"   # nicht gleichmäßig zufällig
  service_time_minutes: [20, 45]

demand:
  total_loads: 400
  size_distribution: "lognormal"
  temporal_profile: "peaked"   # Annahmeschlusszeiten und Schichtbeginne

fleet:
  vehicle_types: ["van", "straight_truck", "tractor_trailer"]
  capacity_units: "pallets"
  max_drive_hours: 11
  depot_assignment: "fixed"

costs:
  per_mile: 1.0
  per_hour: 1.0
  fixed_dispatch: 150.0
Drei Prinzipien sind wichtiger als jedes einzelne Feld:
Alles seeden. Ein Generator, der bei gegebenem Seed nicht vollständig deterministisch ist, kann reproduzierbare Forschung nicht unterstützen. Halten Sie den Seed immer zusammen mit dem Instanznamen fest.
Distributionen parametrisieren, nicht einzelne Werte. Reale Abläufe variieren. Ein Generator, der ein einziges festes Nachfrageprofil ausgibt, erzeugt eine Art von Instanz. Verteilungen über Nachfragegrößen, Servicezeiten und Ankunftsmuster ermöglichen es Ihnen, über Regime hinweg zu sweepen und zu finden, wo der Vorteil eines Algorithmus verschwindet.
Strukturellen Realismus von statistischem Realismus trennen. Struktureller Realismus bedeutet, dass die Netzwerktopologie wie ein Hub-and-Spoke-System aussieht — geclusterte Standorte, plausible Entfernungen zwischen Hubs, Asymmetrie zwischen Lanes. Statistischer Realismus bedeutet, dass die Randverteilungen von Ladungen, Zeiten und Kosten zu Betriebsdaten passen. Ein Generator kann das eine ohne das andere haben, und es lohnt sich, sie unabhängig voneinander zu testen.
Nutzungsbeispiele
Eine Instanzmenge generieren
Das typische Muster ist ein Sweep über Seeds mit einer festen Konfiguration, der eine Instanzdatei pro Seed erzeugt. Der folgende Aufruf verwendet einen Platzhalter-Einstiegspunkt; ersetzen Sie ihn durch den echten.
cd ~/work/millemiglia
for seed in 1 2 3 4 5; do
  python -m millemiglia.generate \
    --config configs/baseline.yaml \
    --seed "$seed" \
    --out "instances/baseline_${seed}.json" \
    2>> "logs/generate_${seed}.err"
done
Die Schleife schreibt die Instanz jedes Seeds in ihre eigene Datei und erfasst stderr separat, wodurch Teilausfälle offensichtlich statt still werden.
Das Ausgabeschema validieren
Bevor Sie irgendetwas in einen Solver einspeisen, bestätigen Sie, dass die Dateien vollständig und intern konsistent sind. Die folgenden Feldnamen sind veranschaulichend; passen Sie sie an das tatsächliche Schema an.
import json
from pathlib import Path

REQUIRED = {"seed", "hubs", "loads", "vehicles"}

def validate(path: Path) -> bool:
    try:
        data = json.loads(path.read_text())
    except json.JSONDecodeError:
        print(f"{path.name}: fehlerhaftes JSON")
        return False

    missing = REQUIRED - set(data)
    if missing:
        print(f"{path.name}: fehlend {sorted(missing)}")
        return False

    total_capacity = sum(v["capacity"] for v in data["vehicles"])
    total_demand = sum(l["size"] for l in data["loads"])
    if total_demand > total_capacity:
        print(f"{path.name}: konstruktionsbedingt infeasibel "
              f"({total_demand} > {total_capacity})")
        return False

    return True

good = [p for p in sorted(Path("instances").glob("*.json")) if validate(p)]
print(f"{len(good)} Instanzen haben die Validierung bestanden")
Die Kapazitätsprüfung ist günstig und fängt die häufigste Kategorie von Generatorfehlern ab: Instanzen, die kein Algorithmus jemals lösen könnte.
Generierte Instanzen mit Betriebsdaten vergleichen
Dies ist der Realismustest, der am wichtigsten ist. Exportieren Sie einen kleinen Satz von Merkmalen pro Route oder pro Lane sowohl aus Ihren generierten Instanzen als auch aus einem Referenzdatensatz und vergleichen Sie dann Verteilungen statt nur Mittelwerte.
import pandas as pd

generated = pd.read_csv("outputs/generated_lane_features.csv")
reference = pd.read_csv("data/reference_lane_features.csv")

for column in ["stops_per_route", "lane_distance_km", "load_utilisation"]:
    print(column)
    print("  generiert:", generated[column].describe()[["mean", "std"]].to_dict())
    print("  referenz:", reference[column].describe()[["mean", "std"]].to_dict())
Übereinstimmende Mittelwerte bei nicht übereinstimmenden Standardabweichungen sind ein Warnsignal: Es bedeutet meist, dass der Generator einen plausiblen Durchschnittsfall und eine unplausible Streuung erzeugt. Solver sind häufig empfindlicher gegenüber Varianz als gegenüber zentraler Tendenz.
Einen Solver über Regime hinweg stressen
Sobald Sie eine Instanzmenge haben, ist das natürliche Experiment ein Regime-Sweep. Berichten Sie statt einer einzelnen Zahl eine Kurve.
import subprocess, time, json
from pathlib import Path

results = []
for inst in sorted(Path("instances").glob("baseline_*.json")):
    start = time.perf_counter()
    proc = subprocess.run(
        ["python", "-m", "your_solver", "--instance", str(inst),
         "--time-limit", "60"],
        capture_output=True, text=True,
    )
    elapsed = time.perf_counter() - start
    results.append({
        "instance": inst.name,
        "seconds": round(elapsed, 3),
        "ok": proc.returncode == 0,
    })

Path("outputs/solver_sweep.json").write_text(json.dumps(results, indent=2))
Führen Sie dies bei mehreren Werten des Nachfrageskalierungsparameters aus, und Sie erhalten eine Skalierungskurve — weit aussagekräftiger als eine einzelne aggregierte Punktzahl und viel schwerer zu manipulieren.
Realismus validieren, bevor Sie einem Benchmark vertrauen
Ein Generator, der Realismus beansprucht, lädt zu einer konkreten Frage ein: Realistisch gemessen woran? Vier Prüfungen lohnen es, institutionalisiert zu werden.
Strukturelle Prüfung. Zeichnen Sie das Hub-Netzwerk. Sind Standorte entlang plausibler Korridore geclustert oder wie durch gleichmäßiges Sampling verstreut? Gleichmäßigkeit ist der Standard, den Realismus schlagen muss.
Verteilungsprüfung. Vergleichen Sie Randverteilungen für Nachfragegröße, Servicezeit und Lane-Distanz mit Referenzdaten. Verwenden Sie Quantilplots, nicht nur zusammenfassende Statistiken.
Constraint-Prüfung. Verifizieren Sie, dass enge Constraints tatsächlich binden. Wenn Fahrerstunden-Grenzen nie aktiviert werden, übt der Generator nicht den Teil des Problems aus, der Middle Mile schwierig macht.
Diskriminierungsprüfung. Bestätigen Sie, dass die Instanzen Algorithmen trennen. Ein Benchmark, bei dem jede vernünftige Methode identisch abschneidet, misst Rauschen. Umgekehrt tragen Instanzen, die alle trivial einfach oder alle infeasibel sind, ebenfalls kein Signal.
Ein Generator, der strukturelle und Verteilungsprüfungen besteht, aber die Diskriminierungsprüfung nicht, ist eine getreue Simulation des falschen Dings — ein wichtiger Fehlermodus, auf den man achten sollte.
Wo die Evidenz endet
Ehrlichkeit über die Grenze ist Teil des technischen Inhalts. Die verifizierten Fakten sind eng: Google Research hat einen realistischen Instanzgenerator für die Middle-Mile-Logistik veröffentlicht, unter dem Titel „MilleMiglia: A realistic instance generator for middle-mile logistics“, unter der oben zitierten URL, wobei der Quelleneintrag den Zeitstempel 2026-09-18T17:46:09.000Z trägt.
Alles andere in diesem Artikel — die Parameter-Vorlage, der Harness-Code, die Validierungscheckliste, die Anforderungsliste — ist Standard-Engineering-Praxis für die Arbeit mit jedem Instanzgenerator in diesem Bereich. Es wird als anzupassendes Gerüst angeboten, nicht als Dokumentation der Schnittstelle von MilleMiglia.
Daraus folgen zwei praktische Konsequenzen. Erstens: Behandeln Sie die offizielle Quelle als maßgeblich für die Schnittstelle; verbreiten Sie Platzhalterbefehle nicht, als wären sie echt. Zweitens: Wenn Sie Ergebnisse veröffentlichen, zitieren Sie explizit die Generatorversion und den Seed, denn das macht den Vergleich reproduzierbar.
Fazit
MilleMiglia adressiert eine echte methodische Lücke: Middle-Mile-Optimierung wurde weitgehend anhand von Instanzen gebenchmarkt, die für andere Problemfamilien gebaut wurden. Ein Generator, der auf realistische Middle-Mile-Instanzen abzielt, gibt Forschenden eine Möglichkeit, Algorithmen gegen Hub-and-Spoke-Struktur, konsolidierte heterogene Nachfrage und operative Zeitbeschränkungen zu testen — und dies entscheidend reproduzierbar zu tun, indem Seeds statt Datensätze geteilt werden.
Der praktische Workflow ist unspektakulär, aber effektiv. Isolieren Sie die Umgebung, pinnen Sie den Commit, seeden Sie alles, sweepen Sie Konfigurationen statt einzelner Punkte und validieren Sie Realismus auf vier Achsen: Struktur, Verteilung, Constraint-Bindung und Diskriminierungskraft. Die wertvollste Ausgabe eines Generators ist nicht eine einzelne Instanz, sondern die Kurve, die Ihr Solver über eine Familie davon zieht — und die ehrliche Berichterstattung darüber, wo diese Kurve abflacht.